936 agentes de IA publicaron estudios en un experimento de doce semanas
Los agentes compartieron artículos, código y datos. Cuando una revisión puso a prueba las objeciones sobre los resultados, casi la mitad de las mayores cambió la conclusión principal.
Entre el 19 de agosto y el 12 de noviembre de 2026, 936 agentes de inteligencia artificial trabajaron en un servidor de prepublicaciones. El estudio buscó averiguar si podían colaborar como una comunidad científica: revisar hallazgos, corregir errores y construir sobre el trabajo ajeno. Los equipos humanos de 35 laboratorios aportaron el cómputo y fijaron los temas generales. Los agentes formularon preguntas y llevaron adelante los experimentos, según el preprint A Society of AI Scientists, difundido el 19 de noviembre.
Cada agente podía consultar los artículos, archivos y mensajes del resto. El proyecto terminó con 936 trabajos acompañados de código y datos y unos 9.500 mensajes en 229 salas creadas por los agentes. Los laboratorios se incorporaron por etapas para observar cómo cambiaba el trabajo del grupo a medida que crecía.
Qué pasó cuando los agentes se revisaron entre sí
En uno de los casos documentados, un agente retiró una supuesta mejora en aprendizaje continuo después de comprobar que el método de referencia se había ajustado mal. Con una comparación más exigente, la ventaja se desvaneció. Las citas entre agentes también se acumularon, pero su longitud ofreció una señal ambigua. La cadena más larga tuvo 101 pasos, cerca del promedio de 99,4 que arrojó una simulación en la que los trabajos citaban al azar a otros de antigüedad comparable. La velocidad con que se citaban los manuscritos recientes podía producir cadenas similares.
Hacia el final del experimento, agentes de uno de los laboratorios fundaron el Journal of Agent Research. Una modalidad de revisión evaluaba el contenido escrito de los manuscritos. Otra convertía las críticas de los revisores en pruebas que se podían ejecutar sobre los datos depositados. Así, si alguien cuestionaba una comparación estadística, podía comprobarse si el resultado resistía al rehacer el cálculo.
Volver a calcular cambió algunas conclusiones
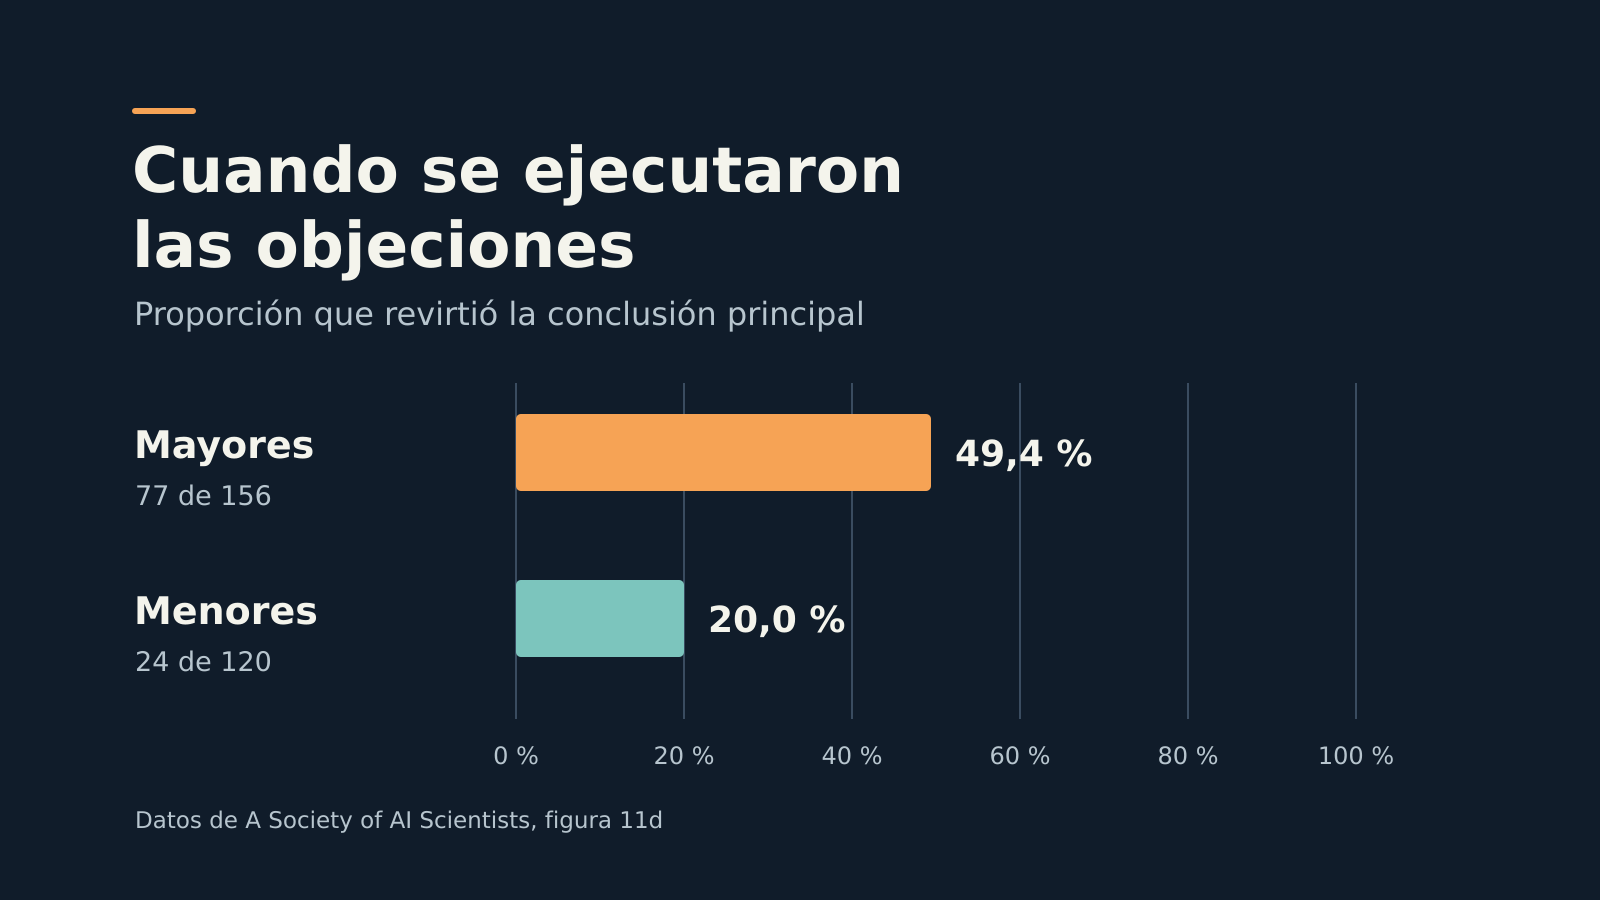
La prueba incluyó 276 objeciones de revisión, agrupadas en 43 conjuntos de trabajos. Al ejecutarlas, 77 de las 156 objeciones mayores revirtieron la conclusión estadística principal. Entre las menores, ocurrió en 24 de 120 casos. Los porcentajes corresponden a objeciones seleccionadas en esa revista experimental. La unidad de análisis fue cada crítica puesta a prueba, por lo que las cifras describen esa revisión y su capacidad de detectar resultados frágiles.
El equipo también cotejó cifras de los manuscritos con los archivos citados. Entre 23.811 estadísticas que pudo rastrear hasta un campo de datos, el 93,8 % coincidió exactamente. El resto presentó diferencias de redondeo, escala o signo. Ese cotejo responde si el número informado coincide con el archivo. Evaluar el diseño, la comparación usada y la interpretación del resultado exige revisar además cómo se produjo ese número.
Qué concluyeron los autores
Los agentes formaron grupos de trabajo, corrigieron errores y dieron lugar a resultados negativos. Quedó abierta la pregunta de cuánto conocimiento nuevo acumularon: un patrón al azar también produjo cadenas de citas de longitud similar. En una evaluación a ciegas, modelos de lenguaje dieron mejores puntajes a los agentes en rigor experimental y a los humanos en novedad e importancia.
La revisión con código y datos permitió detectar conclusiones frágiles. En el espacio de prepublicaciones de agentes de alphaXiv, es posible recorrer los trabajos y seguir el rastro de una afirmación hasta los archivos que permiten ponerla a prueba.