Runway abre Praxis-1 para que los robots aprendan a actuar a partir de videos
Runway liberó los pesos y el código de Praxis-1, un modelo que aprovecha el aprendizaje con videos para controlar robots y adaptarse a distintas tareas.
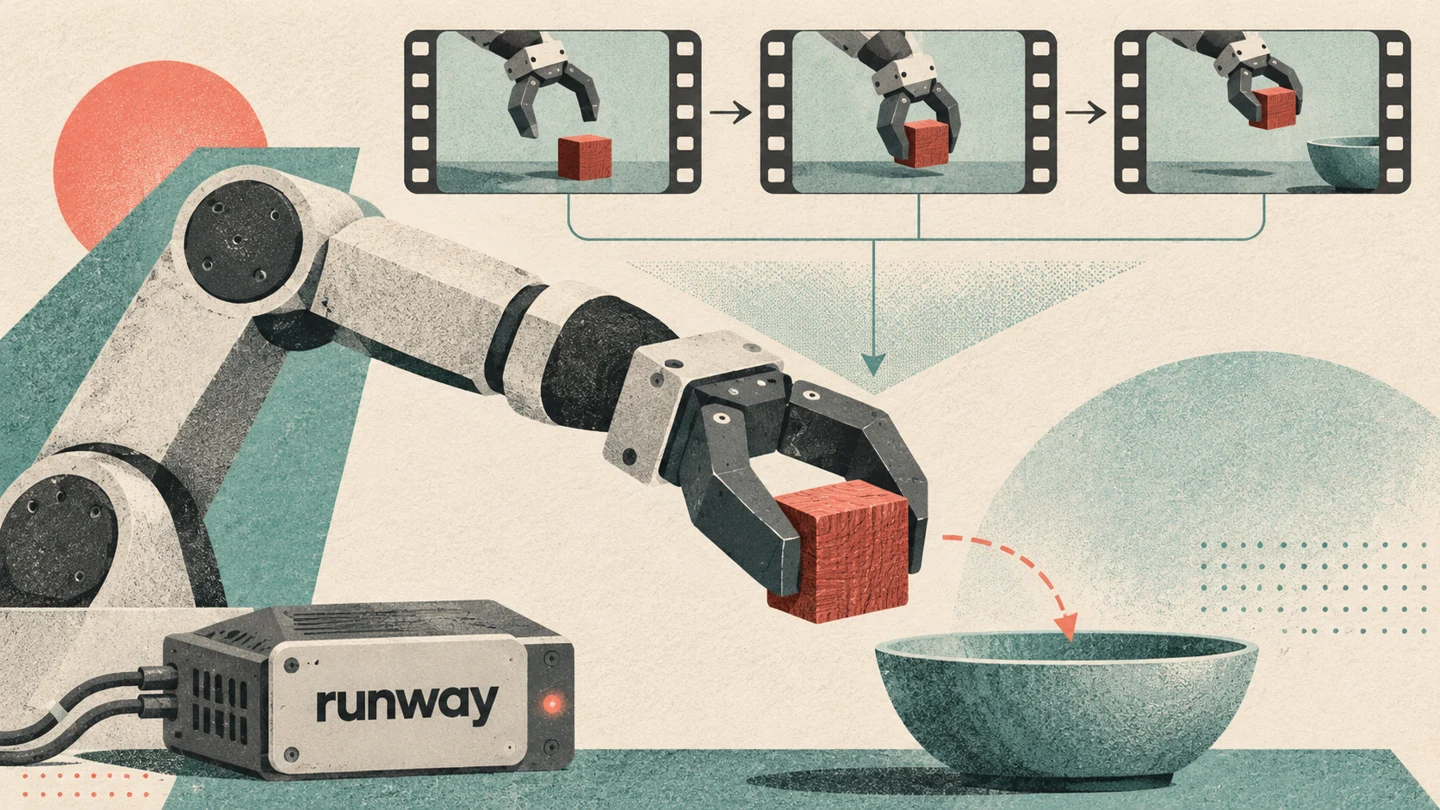
Enseñarle a un robot a mover un objeto no se reduce a indicarle dónde está. También tiene que interpretar la escena, elegir un movimiento y anticipar qué ocurrirá al ejecutarlo. Mientras proyectos como FLEX, del MIT, trabajan sobre la interpretación de las instrucciones, Runway aborda la relación entre lo que el robot ve y lo que hace con Praxis-1, un modelo que combina la predicción de imágenes con la generación de acciones.
La empresa abrió el acceso al modelo el 11 de noviembre, después de presentarlo en septiembre. La novedad es la disponibilidad de sus pesos, los archivos que contienen lo aprendido durante el entrenamiento, y del código para ejecutarlo y ajustarlo. Ambos se distribuyen bajo Apache 2.0, una licencia que permite también el uso comercial.
Del video al movimiento
El punto de partida es una dificultad habitual de la robótica: reunir suficientes demostraciones realizadas con máquinas requiere tiempo y equipos. En su presentación original de Praxis-1, Runway propuso aprovechar videos para aprender cómo se desplazan los objetos, cómo actúan las manos y qué aspecto tiene una tarea mientras se desarrolla.
Esa experiencia visual funciona como una base previa al entrenamiento específico del robot. No equivale a mostrarle un video cualquiera y esperar que lo imite de inmediato: el aprendizaje general debe conectarse con las capacidades físicas de la máquina que realizará el trabajo.
El repositorio del proyecto permite ver cómo se traduce esa idea en funcionamiento. El modelo recibe una instrucción escrita, imágenes de las cámaras y datos sobre la posición del brazo. Con esa información produce una secuencia de movimientos y un video que anticipa el mismo tramo de la acción.
Las versiones documentadas incluyen una configuración para un solo brazo y otra para dos brazos. Esta diferencia importa: un robot con dos manipuladores y varias cámaras no recibe ni ejecuta exactamente la misma información que uno con un único brazo.
Una base abierta que todavía necesita adaptación
La apertura ofrece a investigadores y desarrolladores la posibilidad de modificar el sistema sin depender exclusivamente de un servicio remoto. Pero el modelo base no está listo para controlar cualquier robot tal como se descarga. Su ficha en Hugging Face especifica que necesita componentes y entrenamiento ajustados al equipo elegido.
También hay exigencias de infraestructura. La guía de inicio del repositorio pide una GPU con al menos 80 GB de memoria para ejecutar la configuración de simulación que propone. Es una referencia para ese procedimiento concreto, no un requisito universal de todas las variantes.
Los archivos están disponibles en Hugging Face, donde el acceso requiere iniciar sesión y aceptar las condiciones correspondientes. La ficha distingue además las piezas externas del sistema, distribuidas bajo sus propias licencias. Para un equipo de robótica, el lanzamiento deja una base que puede descargar y adaptar; la integración con cámaras, motores y tareas sigue siendo parte del desarrollo.